목표: 웹서비스가 배포되고 동작하는 전체 과정을 한 바퀴 훑어보기.
전제조건: HTTP, API 등에 대해 알고 있음. 도메인과 IP 주소에 대해 들어본 것 같음. 요청/응답, 라우팅 등의 개념도 그런 게 있다는 건 알고 있음.
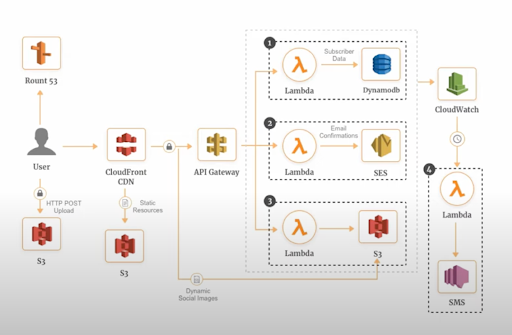
위 아키텍처를 이해하는 것을 목적으로 합니다.
(사진에서 SES, CloudWatch, SMS는 무시)
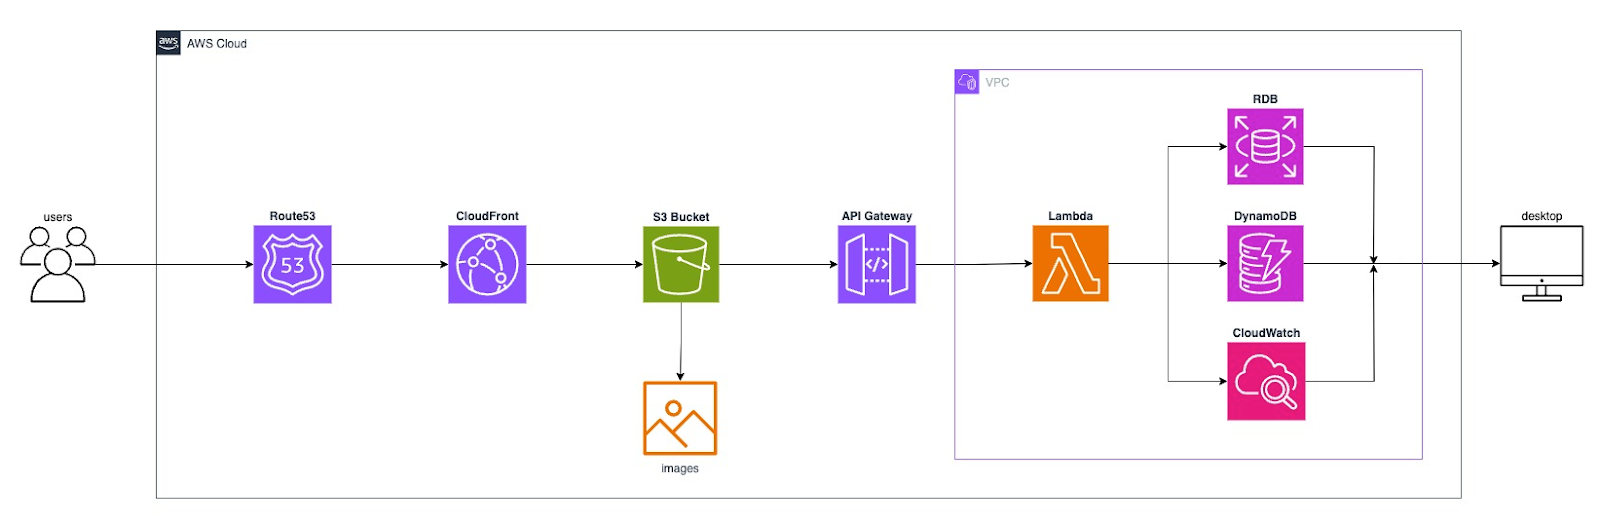
단군 팀의 아키텍처를 보며 아래 설명을 읽어도 괜찮습니다.
1. 리액트 앱 빌드 시 정적 파일(HTML, CSS, JavaScript 등)이 배포 가능한 형태로 생성되는데, 이 파일들을 S3 버킷에 업로드하여 정적 웹사이트를 호스팅
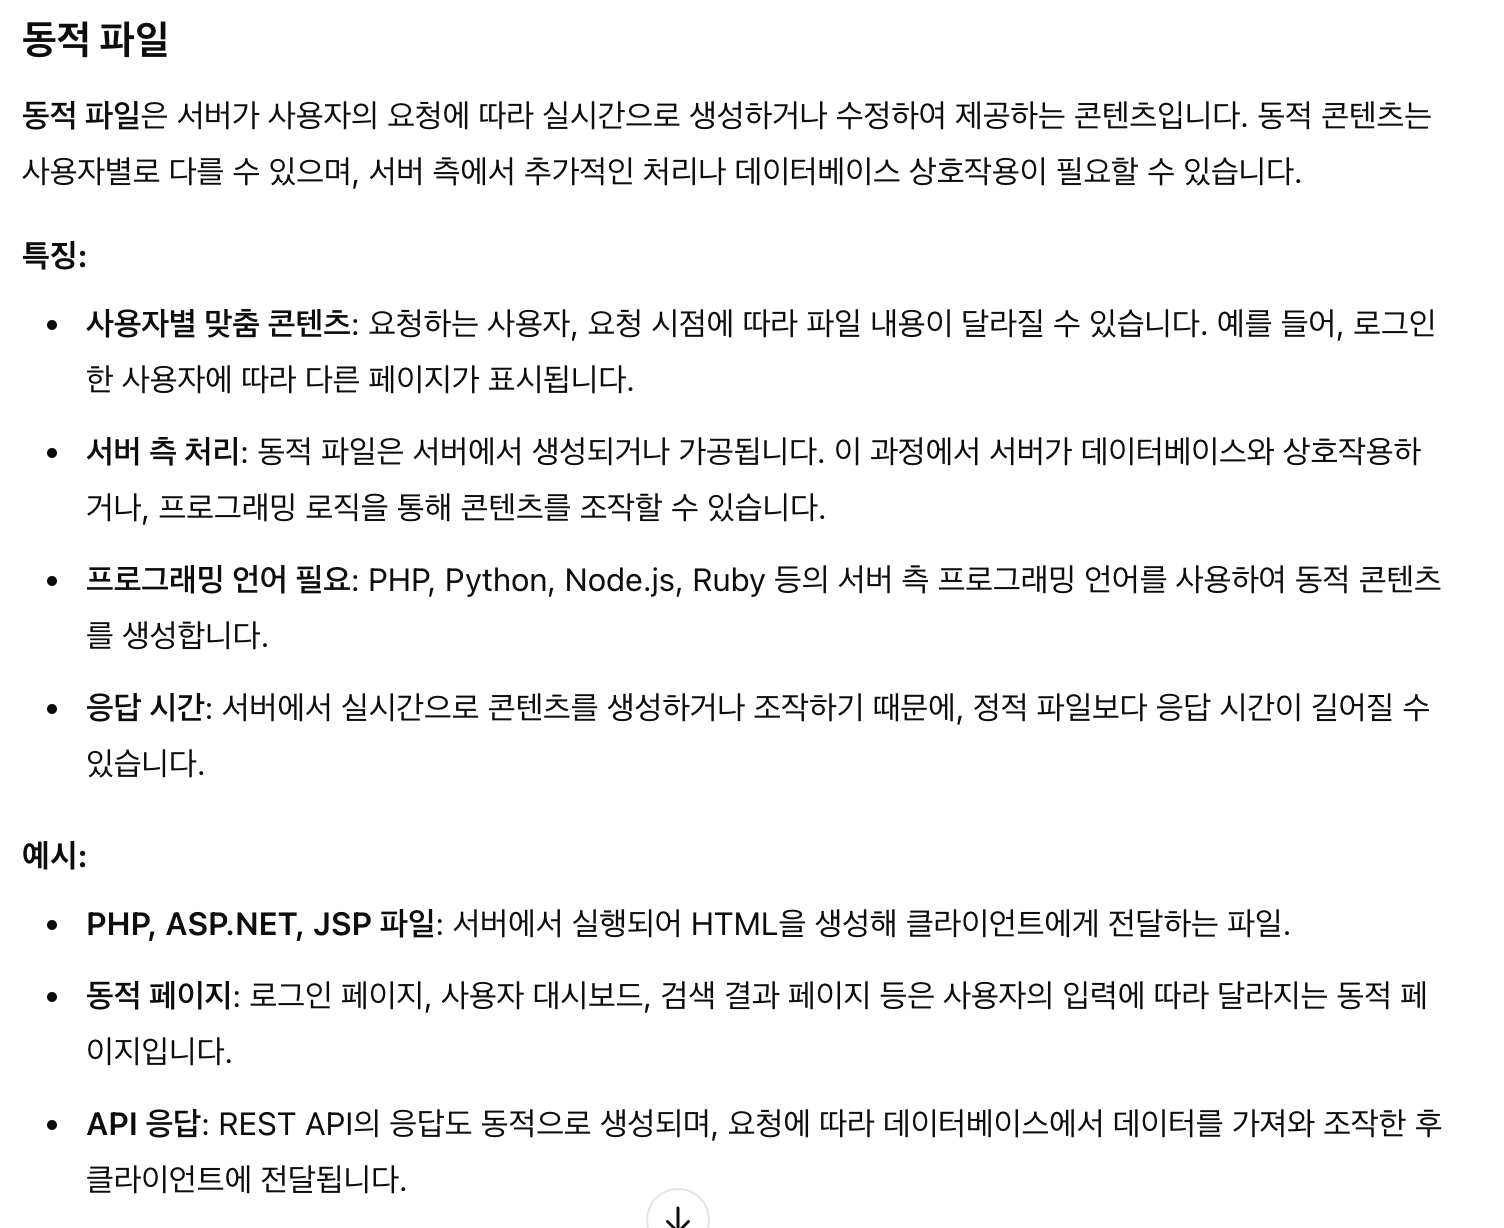
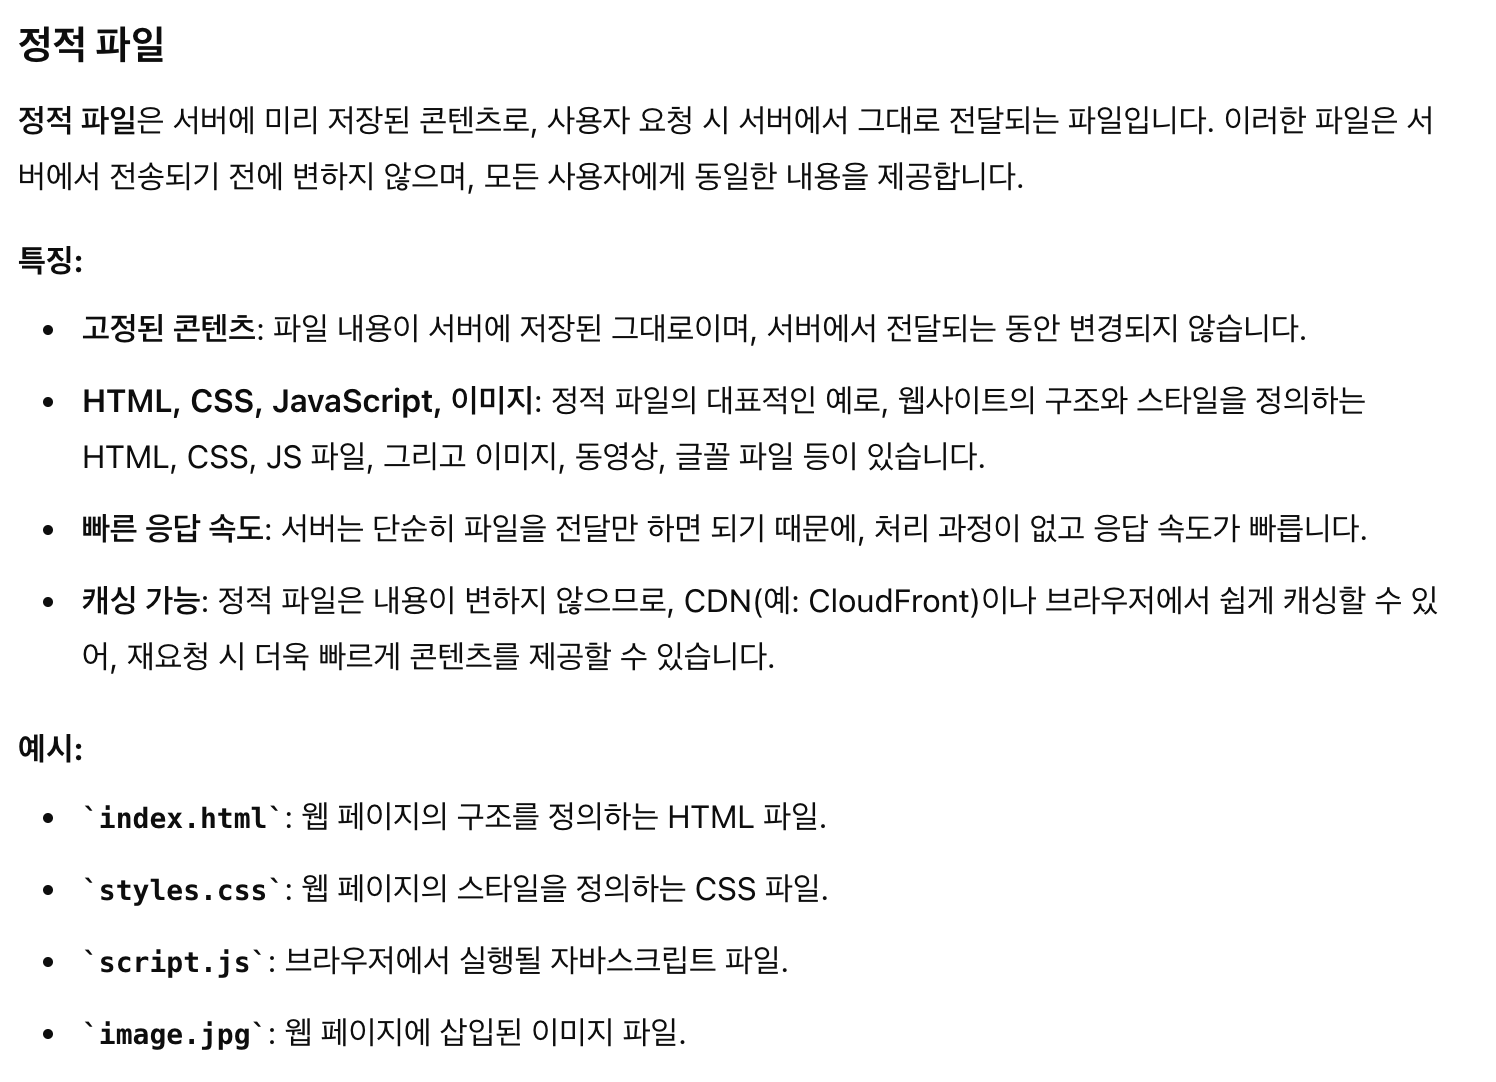 → 여기서 정적 파일이 뭐냐?
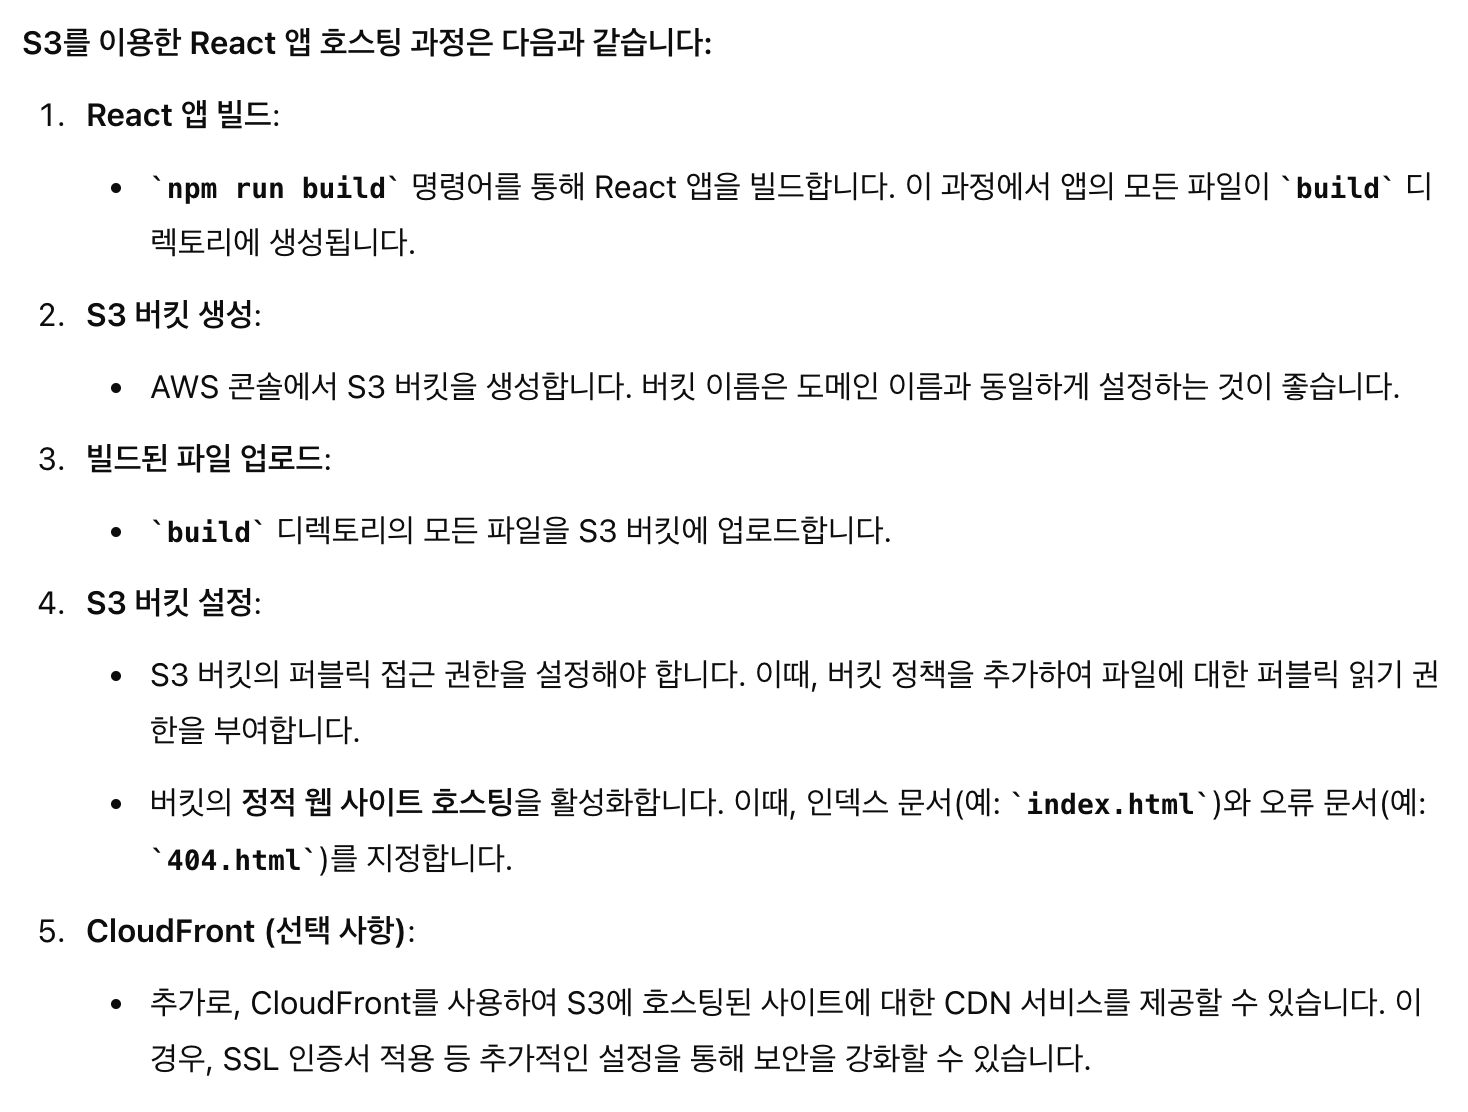
→ 그럼 동적 요소도 있냐?
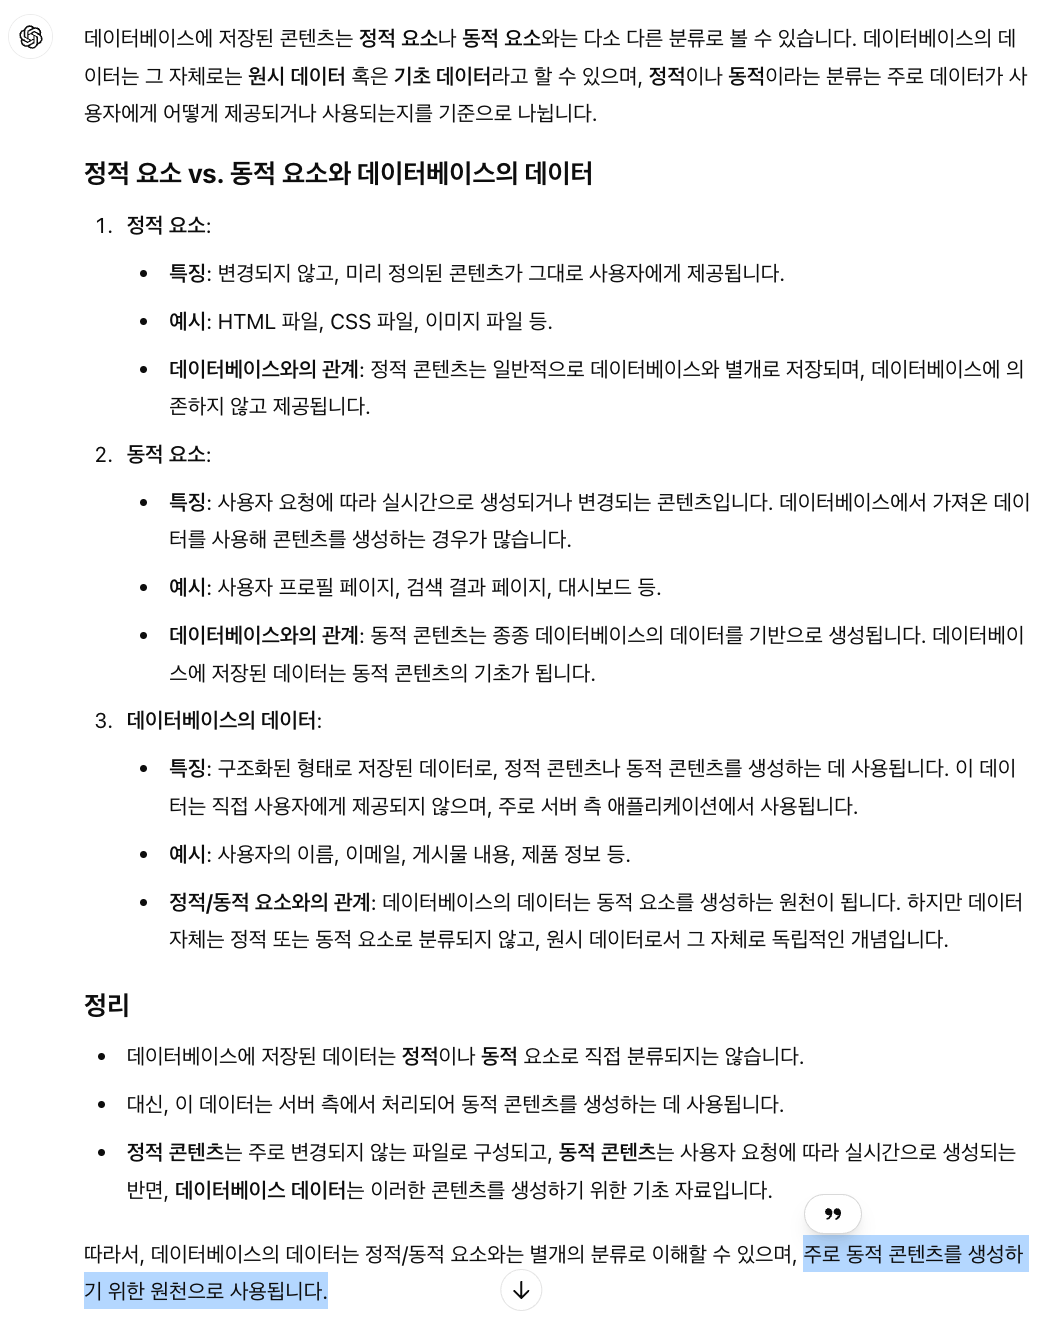
→ 엥 그럼 데이터베이스는 뭐임? 이것도 정적/동적 파일임?
→ CDN은 또 뭐임? (: 몰라도 되는데 알고 싶으면 다음 링크 참고)
https://bosungtea9416.tistory.com/entry/AWS-CloudFront
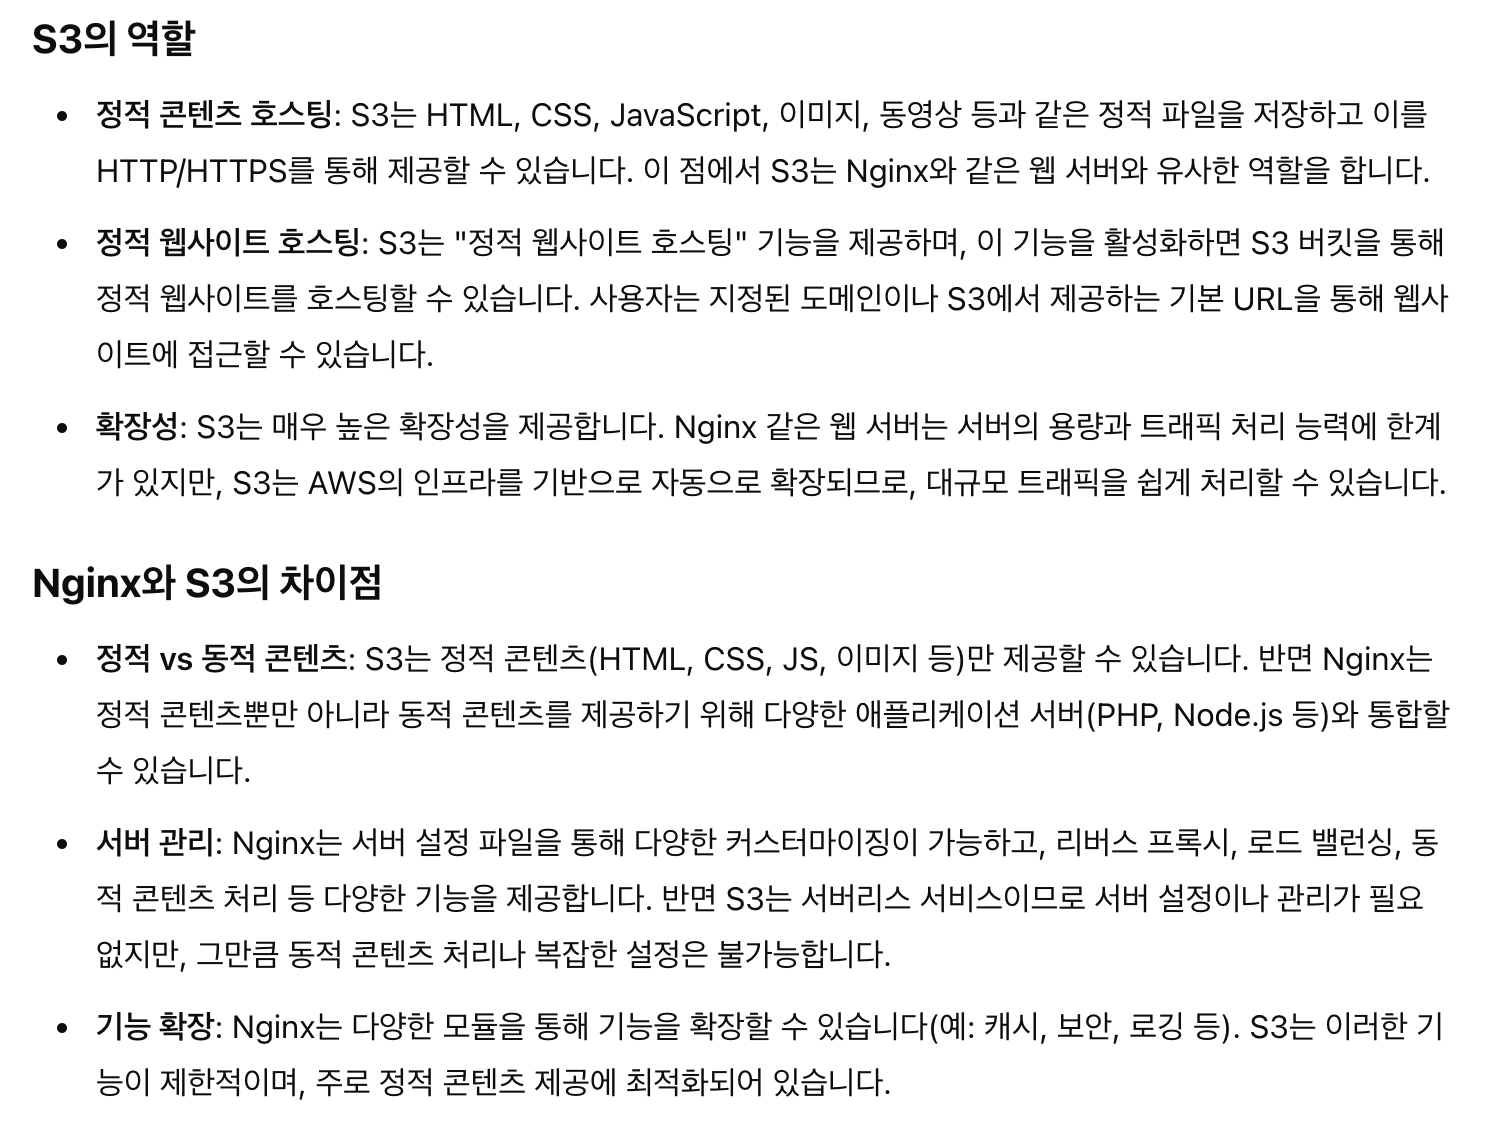
추가: S3가 정확히 뭔가요
https://velog.io/@ghldjfldj/AWS-S3%EB%9E%80-%EB%AC%B4%EC%97%87%EC%9D%B8%EA%B0%80
2. S3에 왜 업로드를 해야 하나?
→ S3에 정적 파일을 업로드하거나, 서버의 파일 시스템에 정적 파일을 저장한 후 NGINX 같은 웹 서버를 통해 제공(우리 수업 때 실습했던 방식)하는 이유?
→ 빌드된 파일들을 HTTP 프로토콜을 통해 다른 사용자들이 브라우저에서 접근할 수 있도록 하기 위함. 이를 통해 브라우저가 해당 파일들이 호스팅된 서버의 IP 주소를 찾아 파일들을 다운로드하고, 사용자들은 웹사이트나 애플리케이션을 이용할 수 있게 됨.
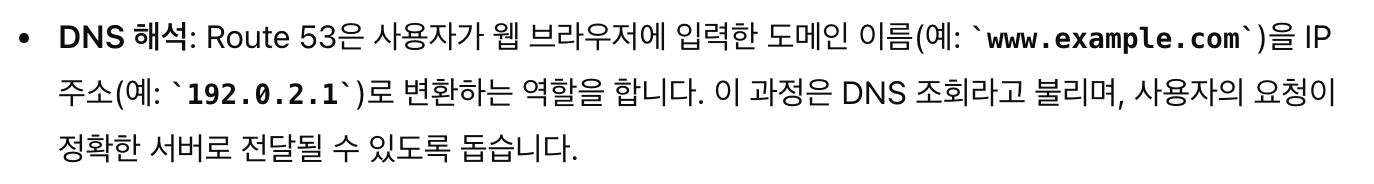
추가: DNS
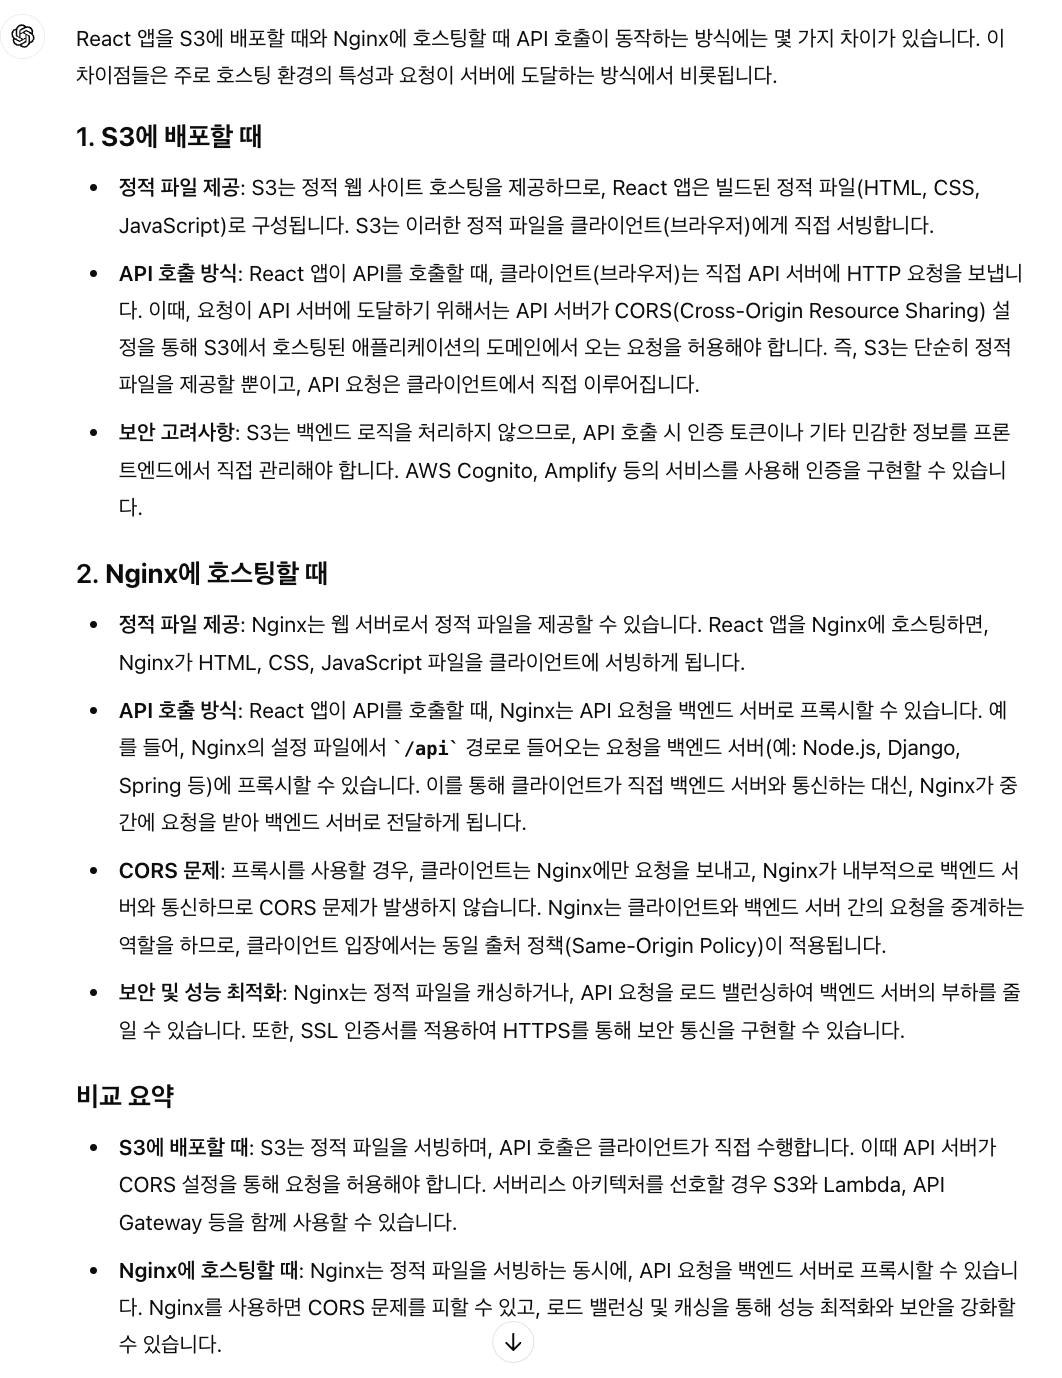
3. API 호출 방식
→ 우리 서비스는 S3에 배포할 것이므로 클라이언트(브라우저)가 직접 API 요청을 해야 함(fetch 또는 axios와 같은 HTTP 클라이언트를 사용하여 API Gateway의 엔드포인트를 직접 호출).
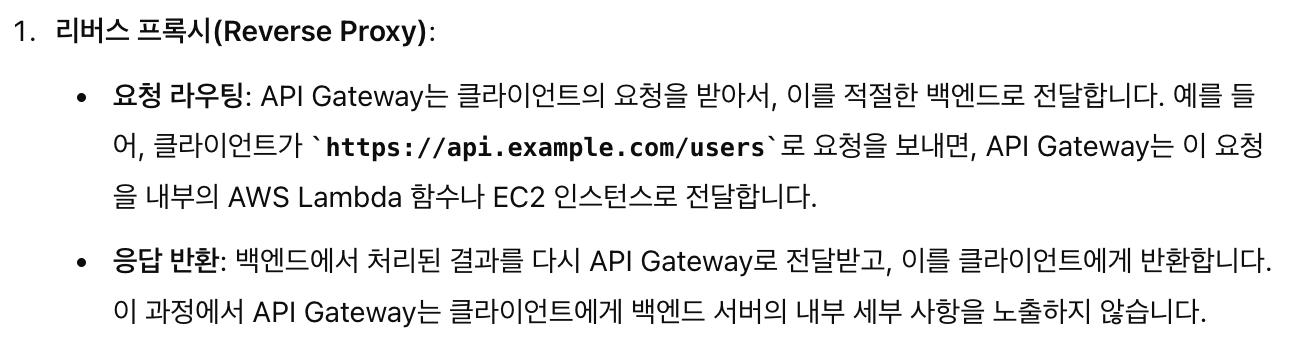
4. API Gateway는 또 뭐냐?
→ 기능이 많은데 우리가 알면 되는 거:
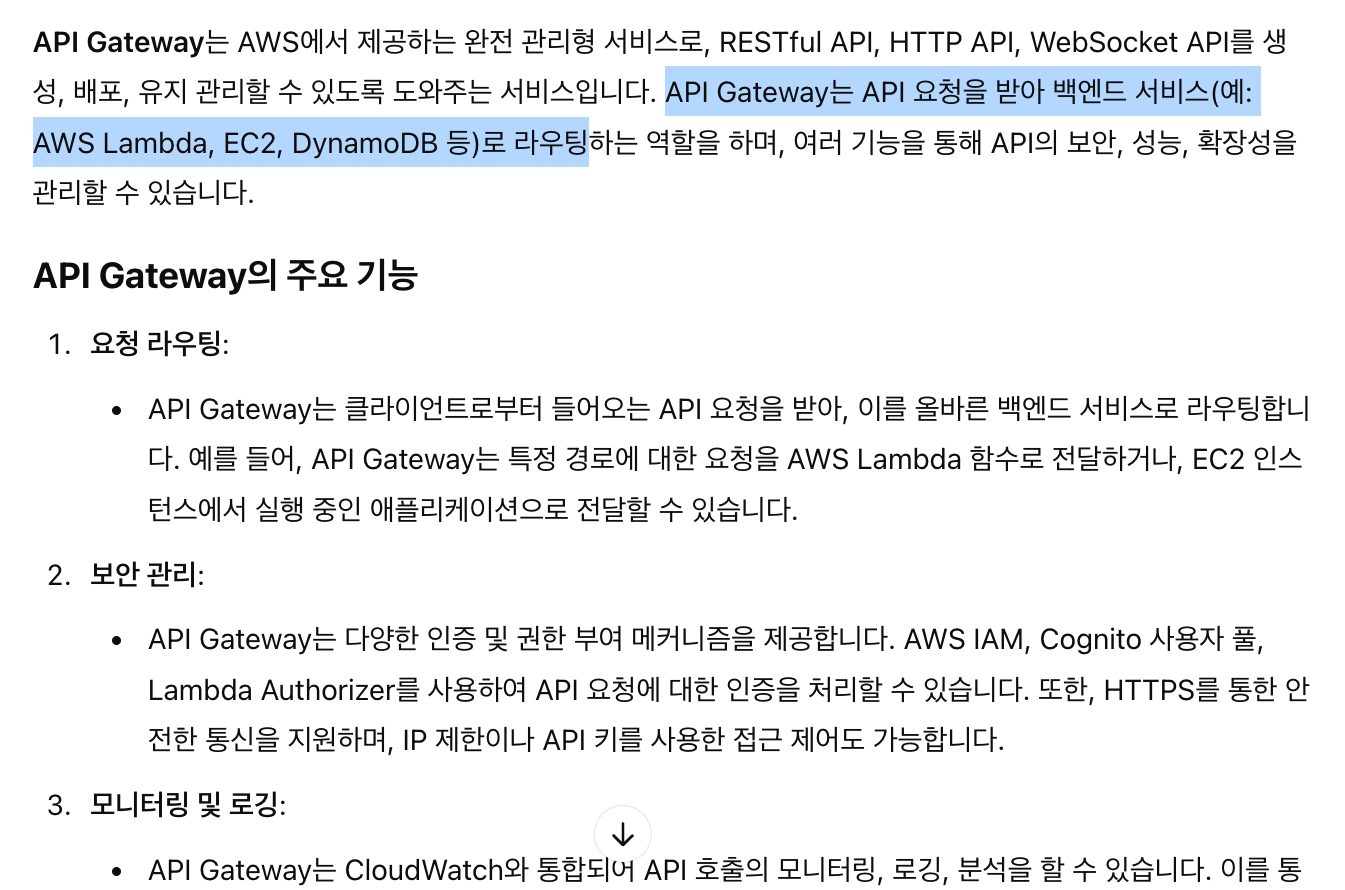
추가: 요청 라우팅 더 자세히 설명
5. 다음 단계(Lambda로 이어지는 경로): 서버리스 동작 방식
→ 저도 모름… 대충 트리거(예: 엔드포인트 설정해 놓고 API Gateway를 통한 클라이언트의 API 요청) 설정해 놓으면 이 이벤트가 발생했을 때 감지해서 연결된 Lambda 함수가 동작하는 방식인 거 같은데 일단 같이 공부해요~
https://www.youtube.com/watch?v=ufLmReluPww
이거 보고 오신 뒤 내일 같이 공부하시면 됩니다
https://youtu.be/7uEDep9DFJs?si=pJZ_WIhuS1FdKEWD
이거 보고 오시면 더 좋음